RESEARCH 01
エッジAI・モデル最適化
EDGE AI / MODEL OPTIMIZATION
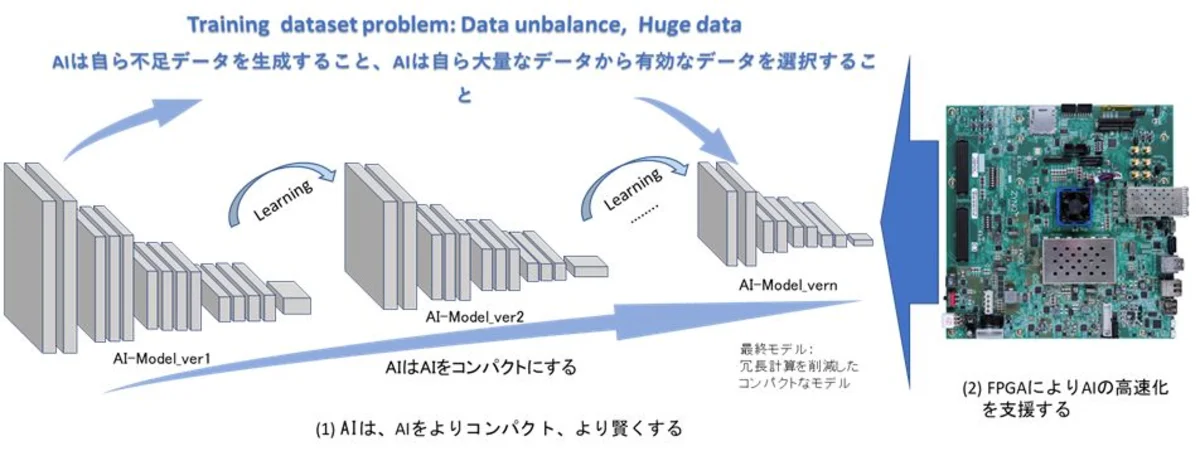
AIを「より小さく、より速く、より省電力に」――限られた計算資源でも高度な深層学習を動かす技術を追求します。
AIを「より小さく、より速く、より省電力に」――限られた計算資源でも高度な深層学習を動かす技術を追求します。
深層学習は画像認識・自然言語処理など多くの分野で飛躍的な成果を上げていますが、その高い精度は膨大な計算量とメモリ消費と引き換えに成り立っています。大規模モデルはクラウドの強力なGPUを前提とすることが多く、スマートフォン・ドローン・センサーといったエッジデバイス上での実時間推論は依然として困難です。
さらに、消費電力・発熱・通信遅延・プライバシーといった現実的な制約は、AIの社会実装を大きく阻んでいます。私たちは「高性能計算(HPC)とコンピュータアーキテクチャ」という研究室の原点に立ち返り、ソフトウェアとハードウェアの両面からこの課題に挑みます。
プルーニング(枝刈り)・量子化・知識蒸留を組み合わせ、精度を保ちながらモデルサイズと計算量を大幅に削減します。層ごとの冗長性を自動的に解析し、ハードウェアの並列性を最大限に引き出す最適化手法(IHSOpti等)を開発しています。
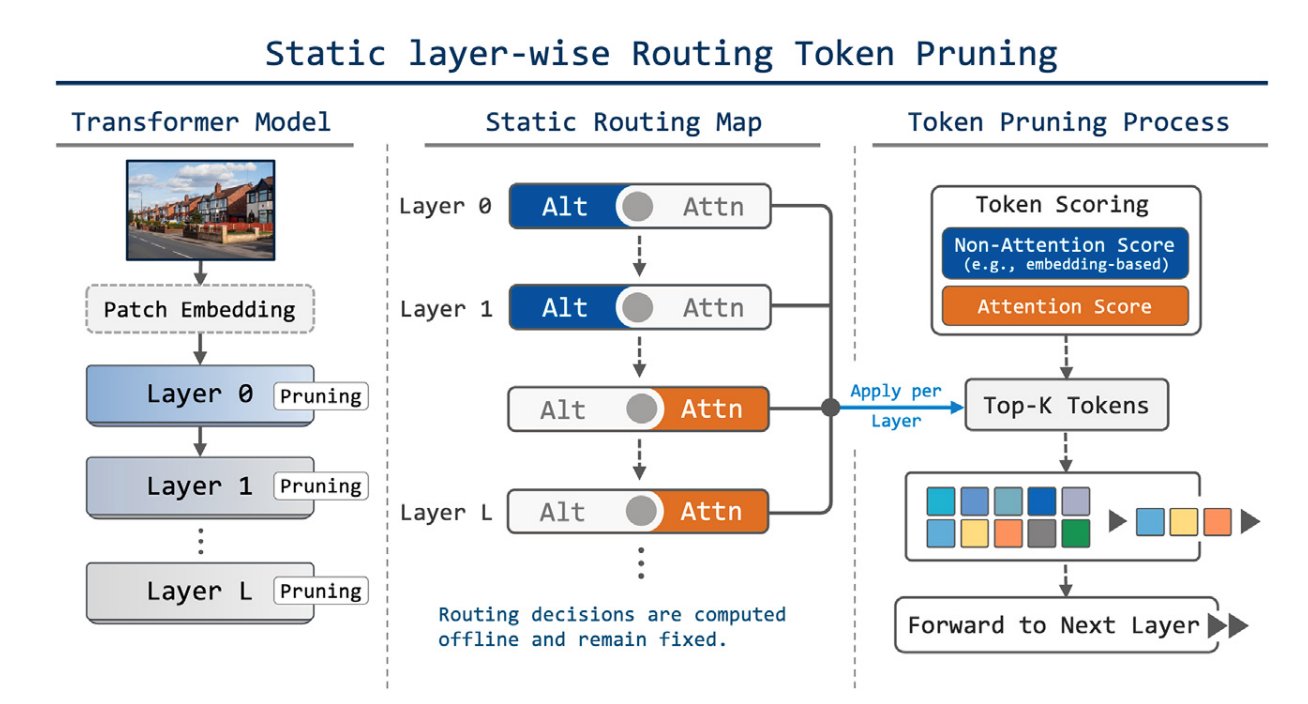
近年主流となったViTに対し、重要度の低いトークンを動的に削減する「トークンプルーニング」を研究。浅い層でのアテンション信頼性の問題に着目し、層に応じた適応的な選択や、Mask2Formerのマルチスケール特徴への独立刈り込みを実現しています。
FPGA / FPGA-DPU / RISC-V を対象に、量子化フレンドリーなAttentionやSIMD命令を活用したカスタムアクセラレータを設計。DPU(Deep Learning Processor Unit)は畳み込みニューラルネットワーク用のプログラマブルエンジンで、既存モデルをプルーニングしてさらにコンパクト化することでDPU上での高速化を図ります。また高位合成(HLS)を用い、C/C++ からFPGAへ実装する回路を生成して深層学習のハードウェアデザインを実現しています。
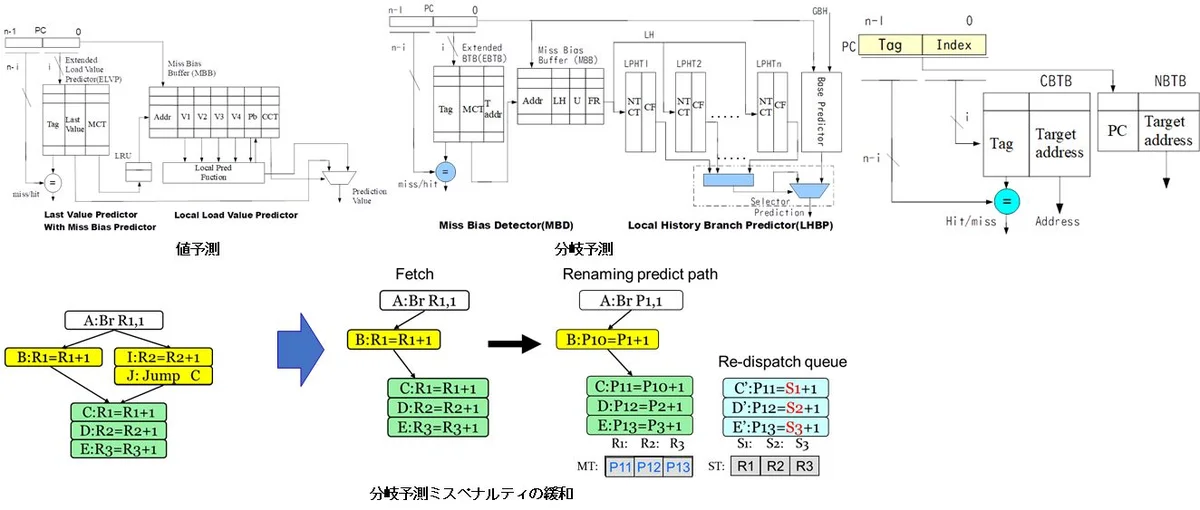
プロセッサアーキテクチャはコンピュータサイエンスの基盤技術であり、応用範囲の拡大に伴いさらなる高速化が求められます。高速化を妨げるデータ依存と制御依存に対して値予測・分岐予測の手法を提案し、予測ミスによって生じるペナルティを緩和する複数の方式を実現してきました。
ViTをエッジとクラウドに分割処理する際の通信ボトルネックに対し、コサイン類似度に基づくトークンクラスタリングで転送データ量を削減する手法を提案しています。